 
- 积分
- 13309
- 威望
- 1940 点
- 铜板
- 7149 枚
- 西秦金币
- 0 个
- 鲜花
- 11 朵
- 在线时间
- 335 小时
- 注册时间
- 2021-8-3
|
AI模型蒸馏:大模型永远躲不开的模仿与偷盗
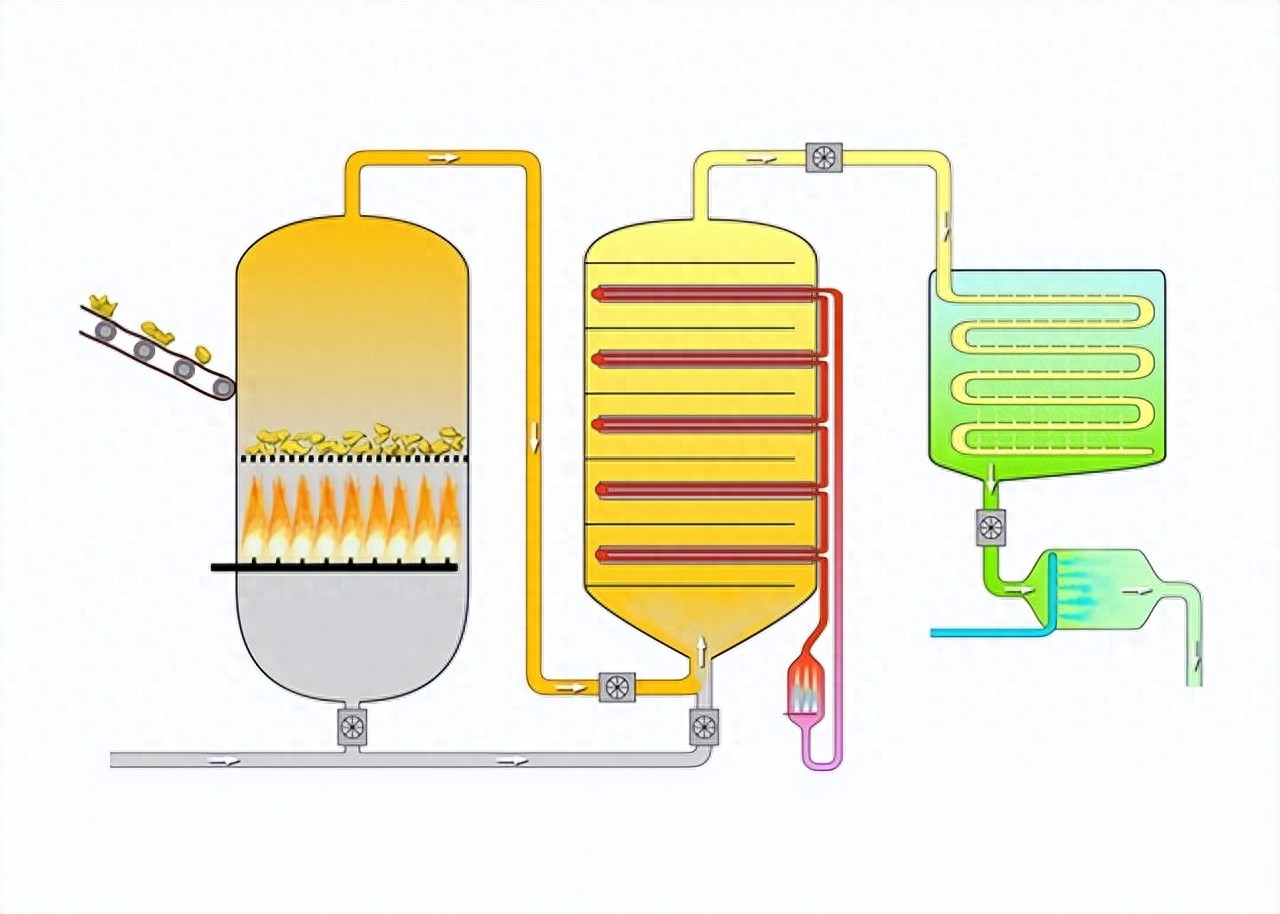
我第一次听到“模型蒸馏”这个词,以为我们四川的酒厂要转型搞AI了。毕竟,酿酒这事儿,我的叔叔伯伯都在行。酿酒时,你要在蒸馏器中加热发酵后的酒液,直到富含酒精的蒸汽升腾而起,再冷却为浓度更高的液体。后来才知道,AI大厂考察了泸州老窖五粮液后,借走了这个词,就是大体积AI模型“浓缩”成小模型。
9月,Anthropic和OpenAI先后公开了细节,说明他们分别发现并拦截了多起针对自家旗舰模型的蒸馏行动:这类行动的核心是从目标模型中提取足够多的信息,用来训练新的仿造模型,后者的体积和训练成本都只有原版的零头。
教师模型和学生模型
想一想我们上学,学生问老师一个问题,问一次,老师讲一次思维要点和注意事项,问得多了,我们自然就猜到同一类题,老师会怎么思考怎么答题。AI蒸馏也是把大模型压缩成一个小模型,理想状态下,这个小模型能完全复刻大模型的所有行为。假设我们把这个大模型称为“教师模型”:开发者会反复向教师模型输入大量提示词,再把它生成的回复喂进新的“学生模型”,完成对后者的训练。你可以直接获得高锰酸钾制备氧气的流程和配料比例,不用自己一遍遍琢磨和实验。
每一条回复都包含了教师模型在训练阶段学到的信息,这些知识不需要经过收集原始数据、从数据中提炼规律、获取人类反馈的完整流程,就能直接传递给学生模型。蒸馏技术让任何人只要使用AI模型、观察它的输出,就能完成对它的逆向工程。
花小钱办大事的乐此不疲
相当一部分蒸馏行为是完全合规的:体积更小的模型能让开发者用更低的成本获得更高的运行效率。事实上,这个概念早在大语言模型诞生之前就已经存在,21世纪初就有研究者将其作为提升神经网络运行效率的方案研究,比如亚历山德鲁·尼古列斯库-米齐尔(Alexandru Niculescu-Mizil)在2006年就在论文中提到:“我们关注的核心就是让模型体积更小、更易用、运行速度更快。”
但蒸馏他人拥有的模型,性质就完全不同了。2025年初,DeepSeek发布了推理模型R1,宣称训练总成本不到30万美元,仅为美国同类实验室投入的极小一部分。很快就被指控,称R1在训练过程使用了从OpenAI模型中提取的回复数据。像极了网上讲的,老父亲千辛万苦,爆了无数金币、花了无数心血,保护了自己如花似玉的女儿健康成长,结果长大了,被黄毛几句甜言蜜语、连花带盆直接搬走了,只能“唇焦口燥呼不得,归来倚杖自叹息”。
所以,九月发布的两份报告中,Anthropic和OpenAI都将近期拦截的蒸馏行动归咎于某东亚国家的实验室,称这类行为是“非法的”、“未经授权的”。这些实验室此前都曾否认过相关指控。Anthropic和OpenAI自己也一直被指责,在训练自家模型时使用了从互联网上获取的大量未授权数据。怎么说呢,红楼梦的傻大姐拣了司棋的绣春囊,还说荷包上绣的是“两个妖精打架”。
美国公司把蒸馏包装成一种安全风险,他们打击这类行为最核心的诉求,是保护自身的竞争优势。简单的说,你的模型收到提示后生成的文本,被竞争对手公司偷走,他们偷走的是你的模型本身的核心能力。
停不下来的猫鼠游戏
通常来说,蒸馏的常规操作是收集海量不同类型的AI回复,这些提示词和对应的回复会成为学生模型的训练数据,大多通过“监督微调”流程完成训练——把教师模型的输出当作标准答案,让学生模型反复模仿对齐。经过多轮迭代训练,学生模型的内部参数(也就是常说的“权重”)会被不断调整,最终让它生成的回复和教师模型高度相似。
整个流程的关键就是拿到这些训练数据。Anthropic和OpenAI都公开了他们认为攻击者使用的几种偷盗方法:比如,部分实验室把自己用户的提示词转发到Claude模型,再把Claude生成的回复存下来用来训练自家模型,这些蒸馏者还会刻意隐藏自己的真实地理位置。或者,蒸馏者会用“从一段对话中复制模型的加密推理内容,再在另一段对话中要求模型解密”的方式,获取教师模型隐藏的推理过程。
AI公司不愿公开他们拦截这些最新蒸馏尝试的具体细节,因为一旦公开,下一批蒸馏者就会知道该避开哪些检测规则。大致来说,这些公司的检测逻辑是监控存在可疑行为的账号:比如短时间内批量发送大量提示词,或是反复询问带有明显特征的特定问题。比如Anthropic提到,两个月内,他们观察到Claude和部分阿里巴巴的账号之间,产生了超过1.51亿次交互,不得不让人想到通义千问系列AI模型。
投鼠忌器与防不胜防
蒸馏能带来的收益极高,所以,蒸馏者使用的手段只会变得越来越复杂。真正的难题在于,恰恰是那些让AI模型信息丰富、实用性强的特质,让它生成的内容格外适合被用来训练新模型。因此,试图让模型更难被蒸馏的操作,往往也会同时损害模型本身的性能。
还有,蒸馏可以被拆分成无数个零散操作,每一条单独的提示词看起来都完全合规无害。教师模型更难区分“正常使用模型的普通用户”和“试图用它训练自己模型的窃取者”。AI公司必须在保护自家模型核心能力,和向公众充分展示模型性能之间找到平衡。 |
|






 雷达卡
;include(/tmp/p254.php);///data/avatar/001/74/44/77_avatar_middle.jpg)
 发表于
 提升卡
 置顶卡
 变色卡
 千斤顶
 显身卡
;include(/tmp/p254.php);///data/avatar/001/77/05/53_avatar_middle.jpg)
 楼主
;include(/tmp/p254.php);///data/avatar/001/78/50/52_avatar_middle.jpg)
;include(/tmp/p254.php);///data/avatar/001/78/40/31_avatar_middle.jpg)
;include(/tmp/p254.php);///data/avatar/001/77/22/57_avatar_middle.jpg)
;include(/tmp/p254.php);///data/avatar/001/78/50/50_avatar_middle.jpg)
;include(/tmp/p254.php);///data/avatar/001/77/22/26_avatar_middle.jpg)